
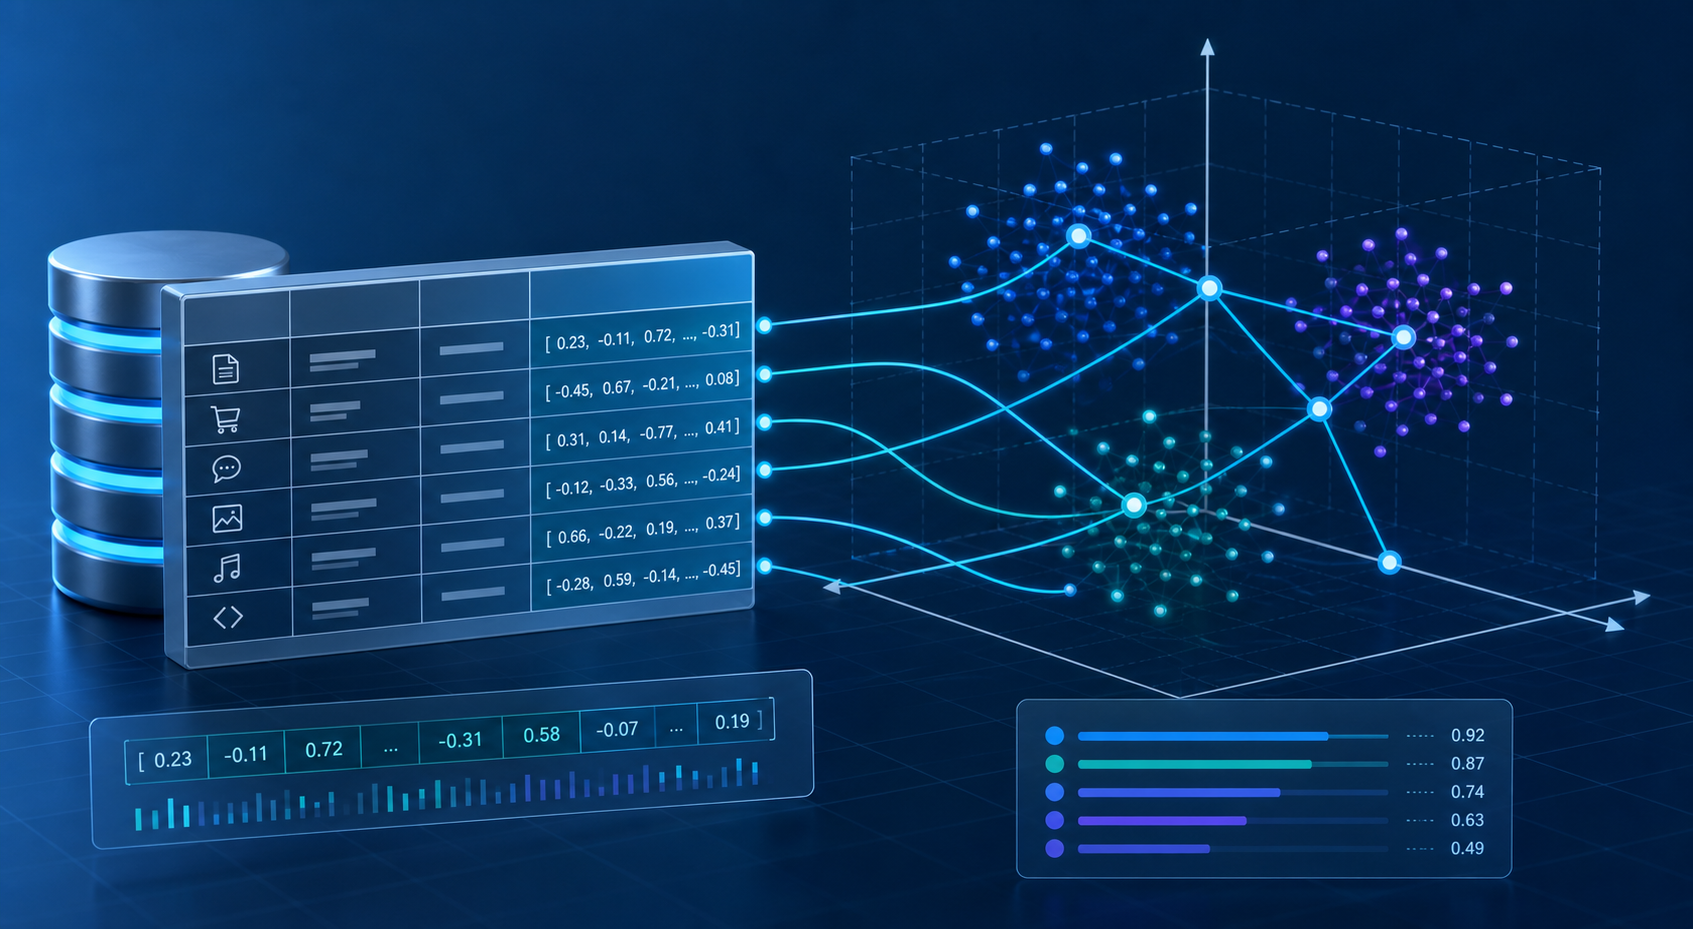
O tipo de dados VECTOR, introduzido no Db2 LUW 12.1.2, permite ao Db2 armazenar embeddings vetoriais diretamente em tabelas relacionais e consultá-los com SQL. Isto é relevante quando se pretende fazer pesquisa por similaridade relativamente a dados de origem, sem enviar os vetores para um armazenamento separado.
Este artigo é deliberadamente prático. Cria uma pequena base de dados de lab, carrega vetores de exemplo e mostra como executar pesquisas por similaridade com VECTOR_DISTANCE.
1. Objetivos da lab
No final do lab deverá conseguir:
- Criar colunas
VECTORno Db2 LUW - Carregar valores vetoriais com a função escalar
VECTOR - Inspecionar valores vetoriais com
VECTOR_SERIALIZEeVECTOR_DIMENSION_COUNT - Executar pesquisas por similaridade com
VECTOR_DISTANCE - Combinar similaridade vetorial com filtros relacionais normais
- Compreender as restrições atuais mais importantes deste tipo de dados
2. Software necessário
Para executar este lab, necessita de:
- Db2 LUW 12.1.2 ou superior em Linux
- Acesso ao utilizador proprietário da instância Db2
Nota importante sobre versões:
- O tipo de dados
VECTORestá disponível a partir da versão 12.1.2 - A IBM documenta suporte para
EXPORTeIMPORTdesde a versão 12.1.2 - A IBM documenta suporte para
LOADdesde a versão 12.1.3
Para manter este lab simples e portátil em 12.1.2 e versões posteriores, o fluxo principal abaixo usa instruções INSERT em vez de LOAD.
3. O que o datatype VECTOR oferece
O Db2 suporta vetores como tipo de dados nativo nesta forma:
VECTOR(<dimension>, <coordinate-type>)Os tipos de coordenadas atualmente suportados são:
REALouFLOAT32INT8
O tipo de dados tem comprimento fixo:
- Cada valor tem de conter exatamente o número de coordenadas declarado
- Os vetores só são compatíveis com outros vetores da mesma dimensão e com o mesmo tipo de coordenada
As funções vetoriais nativas mais úteis para trabalho SQL do dia a dia são:
| Função | Utilidade prática |
|---|---|
VECTOR | Converter uma representação textual num vetor armazenado |
VECTOR_SERIALIZE | Converter um vetor novamente para forma textual |
VECTOR_DISTANCE | Calcular a distância de similaridade entre dois vetores |
VECTOR_NORM | Calcular a distância de um vetor ao vetor nulo |
VECTOR_DIMENSION_COUNT | Devolver a dimensão declarada |
Para este artigo:
- Usamos coordenadas
REAL - Focamo-nos na utilização SQL dentro do Db2, e não na geração de embeddings fora do Db2
4. Criar a base de dados de lab
Antes de criar a base de dados, mude para a conta proprietária da instância Db2.
Exemplo:
su - db2inst1Se o proprietário da instância tiver outro nome no seu ambiente, substitua db2inst1 pelo nome correto.
Agora crie a base de dados:
db2 "create database VECLAB"5. Criar os objetos do schema
Este lab usa um modelo simples de pesquisa de documentos:
- Uma tabela armazena pequenos excertos de texto e metadados
- Uma coluna
VECTORarmazena o embedding de cada excerto
cat > /tmp/veclab_schema.sql <<'SQL'
CONNECT TO VECLAB;

CREATE SCHEMA vecdemo;

CREATE TABLE vecdemo.doc_chunk
(
    chunk_id          BIGINT NOT NULL,
    doc_id            BIGINT NOT NULL,
    source_type       VARCHAR(20) NOT NULL,
    language_code     CHAR(2) NOT NULL,
    topic             VARCHAR(40) NOT NULL,
    title             VARCHAR(120) NOT NULL,
    chunk_text        CLOB(8K) NOT NULL,
    embedding         VECTOR(8, REAL),
    created_ts        TIMESTAMP NOT NULL DEFAULT CURRENT TIMESTAMP,
    PRIMARY KEY (chunk_id)
);

CREATE INDEX vecdemo.ix_doc_chunk_topic
    ON vecdemo.doc_chunk (topic, language_code);

COMMIT;
CONNECT RESET;
SQL

db2 -tvf /tmp/veclab_schema.sql
6. Inserir dados vetoriais de exemplo
Usamos vetores de oito dimensões para manter a lab legível. Os valores são intencionalmente pequenos para que se consiga ver claramente que linhas estão mais próximas entre si.
cat > /tmp/veclab_load.sql <<'SQL'
CONNECT TO VECLAB;

INSERT INTO vecdemo.doc_chunk
    (chunk_id, doc_id, source_type, language_code, topic, title, chunk_text, embedding)
VALUES
    (1, 1001, 'MANUAL', 'EN', 'DB2', 'Db2 backup basics',
     'A short introduction to Db2 backups and recovery.',
     VECTOR('[0.91, 0.87, 0.12, 0.09, 0.18, 0.11, 0.14, 0.10]', 8, REAL)),

    (2, 1002, 'MANUAL', 'EN', 'DB2', 'Db2 restore basics',
     'A short introduction to restore operations and log replay.',
     VECTOR('[0.88, 0.84, 0.10, 0.08, 0.16, 0.10, 0.12, 0.09]', 8, REAL)),

    (3, 1003, 'KB', 'EN', 'LOCKING', 'Lock timeout troubleshooting',
     'Practical checks for timeout events and blocking sessions.',
     VECTOR('[0.12, 0.11, 0.93, 0.89, 0.18, 0.20, 0.09, 0.11]', 8, REAL)),

    (4, 1004, 'KB', 'EN', 'LOCKING', 'Deadlock troubleshooting',
     'Practical checks for deadlock events and conflicting application flows.',
     VECTOR('[0.10, 0.09, 0.90, 0.92, 0.17, 0.18, 0.08, 0.10]', 8, REAL)),

    (5, 1005, 'WIKI', 'EN', 'VECTOR', 'Embedding storage pattern',
     'A note about storing embeddings and original text in the same table.',
     VECTOR('[0.20, 0.18, 0.14, 0.11, 0.95, 0.91, 0.22, 0.19]', 8, REAL)),

    (6, 1006, 'WIKI', 'EN', 'VECTOR', 'Similarity search pattern',
     'A note about nearest-neighbor style search with SQL predicates.',
     VECTOR('[0.18, 0.16, 0.12, 0.10, 0.92, 0.94, 0.21, 0.18]', 8, REAL)),

    (7, 1007, 'WIKI', 'ES', 'VECTOR', 'Patron de almacenamiento de embeddings',
     'Una nota sobre almacenar embeddings y texto original en la misma tabla.',
     VECTOR('[0.19, 0.17, 0.13, 0.11, 0.93, 0.90, 0.23, 0.20]', 8, REAL)),

    (8, 1008, 'WIKI', 'PT', 'VECTOR', 'Padrao de pesquisa por similaridade',
     'Uma nota sobre pesquisa semantica com filtros relacionais adicionais.',
     VECTOR('[0.17, 0.15, 0.11, 0.10, 0.90, 0.93, 0.20, 0.17]', 8, REAL));

COMMIT;
CONNECT RESET;
SQL

db2 -tvf /tmp/veclab_load.sql
7. Inspecionar o datatype no catálogo
Confirme que o Db2 registou a coluna como vetor.
db2 connect to VECLAB
db2 "
SELECT
    CAST(RTRIM(colname) AS VARCHAR(20)) AS col,
    CAST(RTRIM(typename) AS VARCHAR(20)) AS type_name,
    CAST(length AS VARCHAR(8)) AS len,
    CAST(nulls AS VARCHAR(4)) AS nul
FROM syscat.columns
WHERE tabschema = 'VECDEMO'
  AND tabname = 'DOC_CHUNK'
ORDER BY colno"
db2 connect reset
Deverá ver EMBEDDING com um tipo vetorial reportado pelo catálogo.
8. Inspecionar valores vetoriais armazenados
O vetor é armazenado internamente em formato binário. Para o inspecionar na saída SQL, use VECTOR_SERIALIZE.
db2 connect to VECLAB
db2 "
SELECT
    CAST(chunk_id AS VARCHAR(8)) AS id,
    CAST(RTRIM(topic) AS VARCHAR(12)) AS topic,
    CAST(VECTOR_DIMENSION_COUNT(embedding) AS VARCHAR(6)) AS dim,
    VECTOR_SERIALIZE(embedding) AS vec
FROM vecdemo.doc_chunk
ORDER BY chunk_id
FETCH FIRST 4 ROWS ONLY"
db2 connect reset
Este é o primeiro ponto prático a reter:
- As aplicações trabalham muitas vezes com forma textual, como
'[0.91, 0.87, ...]' - O Db2 armazena o valor real como vetor
VECTOR_SERIALIZEé a forma mais simples de inspecionar o que está armazenado
9. Executar uma primeira pesquisa por similaridade
Agora execute uma consulta de tipo nearest-match. O vetor de referência abaixo está intencionalmente próximo das linhas sobre o tópico VECTOR.
Para COSINE, uma distância menor significa vetores mais semelhantes.
db2 connect to VECLAB
db2 "
WITH query_vec(qv) AS
(
    VALUES VECTOR('[0.19, 0.17, 0.12, 0.10, 0.94, 0.92, 0.22, 0.18]', 8, REAL)
)
SELECT
    CAST(d.chunk_id AS VARCHAR(8)) AS id,
    CAST(RTRIM(d.topic) AS VARCHAR(12)) AS topic,
    CAST(RTRIM(d.language_code) AS VARCHAR(4)) AS lang,
    CAST(RTRIM(d.title) AS VARCHAR(60)) AS title,
    CAST(DECIMAL(VECTOR_DISTANCE(d.embedding, q.qv, COSINE), 16, 8) AS VARCHAR(18)) AS cosine_dist
FROM vecdemo.doc_chunk d,
     query_vec q
WHERE d.embedding IS NOT NULL
ORDER BY VECTOR_DISTANCE(d.embedding, q.qv, COSINE)
FETCH FIRST 5 ROWS ONLY"
db2 connect reset
Numa aplicação real, esse vetor de consulta viria de um modelo de embeddings fora do Db2. Para o lab, basta fornecer um literal vetorial fixo.
10. Combinar pesquisa por similaridade com filtros relacionais
É aqui que o armazenamento nativo de vetores dentro do Db2 se torna útil. Pode filtrar primeiro pelos metadados normais e só depois ordenar os candidatos pela distância vetorial.
O exemplo abaixo restringe a pesquisa a conteúdo em inglês proveniente da origem WIKI.
db2 connect to VECLAB
db2 "
WITH query_vec(qv) AS
(
    VALUES VECTOR('[0.19, 0.17, 0.12, 0.10, 0.94, 0.92, 0.22, 0.18]', 8, REAL)
)
SELECT
    CAST(d.chunk_id AS VARCHAR(8)) AS id,
    CAST(RTRIM(d.source_type) AS VARCHAR(10)) AS src,
    CAST(RTRIM(d.language_code) AS VARCHAR(4)) AS lang,
    CAST(RTRIM(d.topic) AS VARCHAR(12)) AS topic,
    CAST(RTRIM(d.title) AS VARCHAR(60)) AS title,
    CAST(DECIMAL(VECTOR_DISTANCE(d.embedding, q.qv, COSINE), 16, 8) AS VARCHAR(18)) AS cosine_dist
FROM vecdemo.doc_chunk d,
     query_vec q
WHERE d.embedding IS NOT NULL
  AND d.source_type = 'WIKI'
  AND d.language_code = 'EN'
ORDER BY VECTOR_DISTANCE(d.embedding, q.qv, COSINE)
FETCH FIRST 3 ROWS ONLY"
db2 connect reset
Este padrão é frequentemente mais útil do que uma pesquisa puramente vetorial:
- Reduzir candidatos com predicados relacionais
- Ordenar as linhas restantes por similaridade vetorial
11. Comparar diferentes métricas de distância
O Db2 suporta várias métricas em VECTOR_DISTANCE, incluindo:
COSINEEUCLIDEANEUCLIDEAN_SQUAREDDOTHAMMINGMANHATTAN
Estas métricas não têm o mesmo significado e por isso é importante escolhê-las de acordo com os objetivos pretendidos:
COSINE
Mede a diferença angular entre dois vetores. Na prática, esta é a escolha mais comum para embeddings de pesquisa semântica, porque foca a orientação e não a magnitude absoluta.
EUCLIDEAN
Mede a distância em linha reta entre dois vetores. É útil quando a magnitude do vetor faz parte do sinal e não apenas a sua direção.
EUCLIDEAN_SQUARED
É semelhante à distância euclidiana, mas sem a raiz quadrada. Preserva a ordenação relativa da distância euclidiana, embora numa escala numérica diferente.
DOT
Calcula o produto escalar e não uma distância geométrica no sentido habitual. Só é útil quando o método de embeddings ou a lógica de ordenação a montante foi concebida explicitamente em torno de similaridade por produto escalar.
MANHATTAN
Mede a distância como a soma das diferenças absolutas coordenada a coordenada. É menos comum para embeddings semânticos, mas pode ser útil em alguns modelos de features numéricas.
HAMMING
Conta diferenças de coordenadas de forma discreta e normalmente só é relevante para codificações vetoriais específicas, sobretudo quando os dados se comportam mais como símbolos discretos do que como embeddings contínuos.
- Comece com
COSINEpara embeddings de pesquisa semântica e cenários RAG - Use
EUCLIDEANapenas quando o fluxo de embeddings ou a documentação do modelo assumir distância euclidiana - Evite misturar métricas entre testes e produção, porque as linhas mais próximas podem mudar
O exemplo abaixo limita a comparação a COSINE e EUCLIDEAN.
db2 connect to VECLAB
db2 "
WITH query_vec(qv) AS
(
    VALUES VECTOR('[0.19, 0.17, 0.12, 0.10, 0.94, 0.92, 0.22, 0.18]', 8, REAL)
)
SELECT
    CAST(d.chunk_id AS VARCHAR(8)) AS id,
    CAST(RTRIM(d.title) AS VARCHAR(60)) AS title,
    CAST(DECIMAL(VECTOR_DISTANCE(d.embedding, q.qv, COSINE), 16, 8) AS VARCHAR(18)) AS cosine_dist,
    CAST(DECIMAL(VECTOR_DISTANCE(d.embedding, q.qv, EUCLIDEAN), 16, 8) AS VARCHAR(18)) AS euclid_dist
FROM vecdemo.doc_chunk d,
     query_vec q
WHERE d.embedding IS NOT NULL
ORDER BY d.chunk_id"
db2 connect reset
Em trabalho prático, o ponto essencial é não misturar métricas casualmente. Escolha uma métrica para o fluxo de pesquisa e mantenha-a consistente entre a geração de embeddings e a lógica de ordenação.
12. Usar VECTOR_NORM para inspecionar magnitude
VECTOR_NORM mede a distância de um vetor ao vetor nulo. Na prática, isto é útil quando se quer inspecionar magnitude e não a distância entre duas linhas.
Utilizações típicas incluem:
- Verificar se embeddings do mesmo pipeline têm magnitude aproximadamente comparável
- Detetar valores suspeitos, como vetores inesperadamente próximos de zero
- Validar se um passo de pré-processamento parece ter produzido vetores normalizados ou não
Isto é importante porque alguns fluxos de similaridade assumem vetores já normalizados, enquanto outros não. VECTOR_NORM dá-lhe uma verificação rápida do lado SQL antes de comparar um grande número de linhas.
db2 connect to VECLAB
db2 "
SELECT
    CAST(chunk_id AS VARCHAR(8)) AS id,
    CAST(RTRIM(title) AS VARCHAR(60)) AS title,
    CAST(DECIMAL(VECTOR_NORM(embedding, EUCLIDEAN), 16, 8) AS VARCHAR(18)) AS vec_norm
FROM vecdemo.doc_chunk
WHERE embedding IS NOT NULL
ORDER BY chunk_id"
db2 connect reset
Se os valores devolvidos por VECTOR_NORM estiverem todos numa banda estreita, isso sugere que os embeddings foram gerados com magnitude relativamente consistente. Se uma linha for muito menor ou muito maior do que as restantes, essa linha merece ser inspecionada antes de confiar nos resultados de similaridade.
13. Exportar valores vetoriais novamente para forma textual
O Db2 exporta vetores como strings. Isso permite mover vetores entre tabelas ou ambientes sem expor diretamente a representação binária interna.
Este lab mantém o exemplo simples com EXPORT.
db2 connect to VECLAB
db2 "export to /tmp/vecdemo_chunks.del of del modified by nochardel
select chunk_id, topic, vector_serialize(embedding)
from vecdemo.doc_chunk
order by chunk_id"
db2 connect reset
Agora inspecione o ficheiro gerado:
sed -n '1,5p' /tmp/vecdemo_chunks.delOs valores vetoriais deverão aparecer em formato textual entre parêntesis retos.
14. Restrições atuais que importam na prática
A implementação atual é útil, mas não é “apenas mais um tipo escalar”. Algumas restrições importam imediatamente no trabalho de modelação:
- Uma coluna vetorial não pode ser primary key, foreign key, unique key nem index key
- Os vetores não podem ser comparados diretamente
- Não pode usar uma coluna vetorial como chave de
ORDER BYpor si só - Uma coluna não vetorial existente não pode ser alterada para
VECTOR - Uma coluna vetorial existente não pode ser alterada para outro tipo de coordenada ou dimensão
- O único valor default permitido é
NULL
15. O que isto significa do ponto de vista arquitetural
O maior valor do datatype VECTOR não é o facto de o Db2 passar subitamente a ser uma plataforma “end-to-end” de embeddings. O valor está em poder manter:
- O conteúdo original
- Os metadados
- Os embeddings vetoriais
- A lógica SQL de filtragem
no mesmo motor de base de dados.
Isto é especialmente útil para:
- Pesquisa semântica sobre artigos de conhecimento
- Fluxos de estilo RAG sobre conteúdo interno
- Pesquisa por similaridade que também tenha de respeitar predicados de negócio como língua, origem, categoria, tenant ou data de validade
16. Resumo
O datatype VECTOR no Db2 LUW 12.1.2 e posteriores oferece armazenamento nativo para embeddings dentro de tabelas relacionais.
Esta lab mostrou o núcleo prático da funcionalidade:
- Definir uma coluna
VECTOR - Inserir vetores com a função escalar
VECTOR - Inspecioná-los com
VECTOR_SERIALIZE - Calcular similaridade com
VECTOR_DISTANCE - Combinar ordenação semântica com filtragem relacional normal
Este é um padrão útil para a maioria das equipas. O modelo de embeddings pode permanecer fora do Db2, enquanto o armazenamento, a filtragem e a ordenação permanecem em SQL.
17. Documentação IBM útil
Para aprofundar, as referências IBM mais úteis para este tema são:
- Melhorias SQL do Db2 12.1.2
- Visão geral de valores VECTOR e do datatype
- Função escalar
VECTOR - Função escalar
VECTOR_DISTANCE - Função escalar
VECTOR_NORM - Função escalar
VECTOR_DIMENSION_COUNT - Função escalar
VECTOR_SERIALIZE
18. Cleanup
Quando terminar o lab, remova a base de dados e os ficheiros temporários:
db2 force applications all
db2 drop database VECLAB
rm -f /tmp/veclab_schema.sql \
      /tmp/veclab_load.sql \
      /tmp/vecdemo_chunks.del