
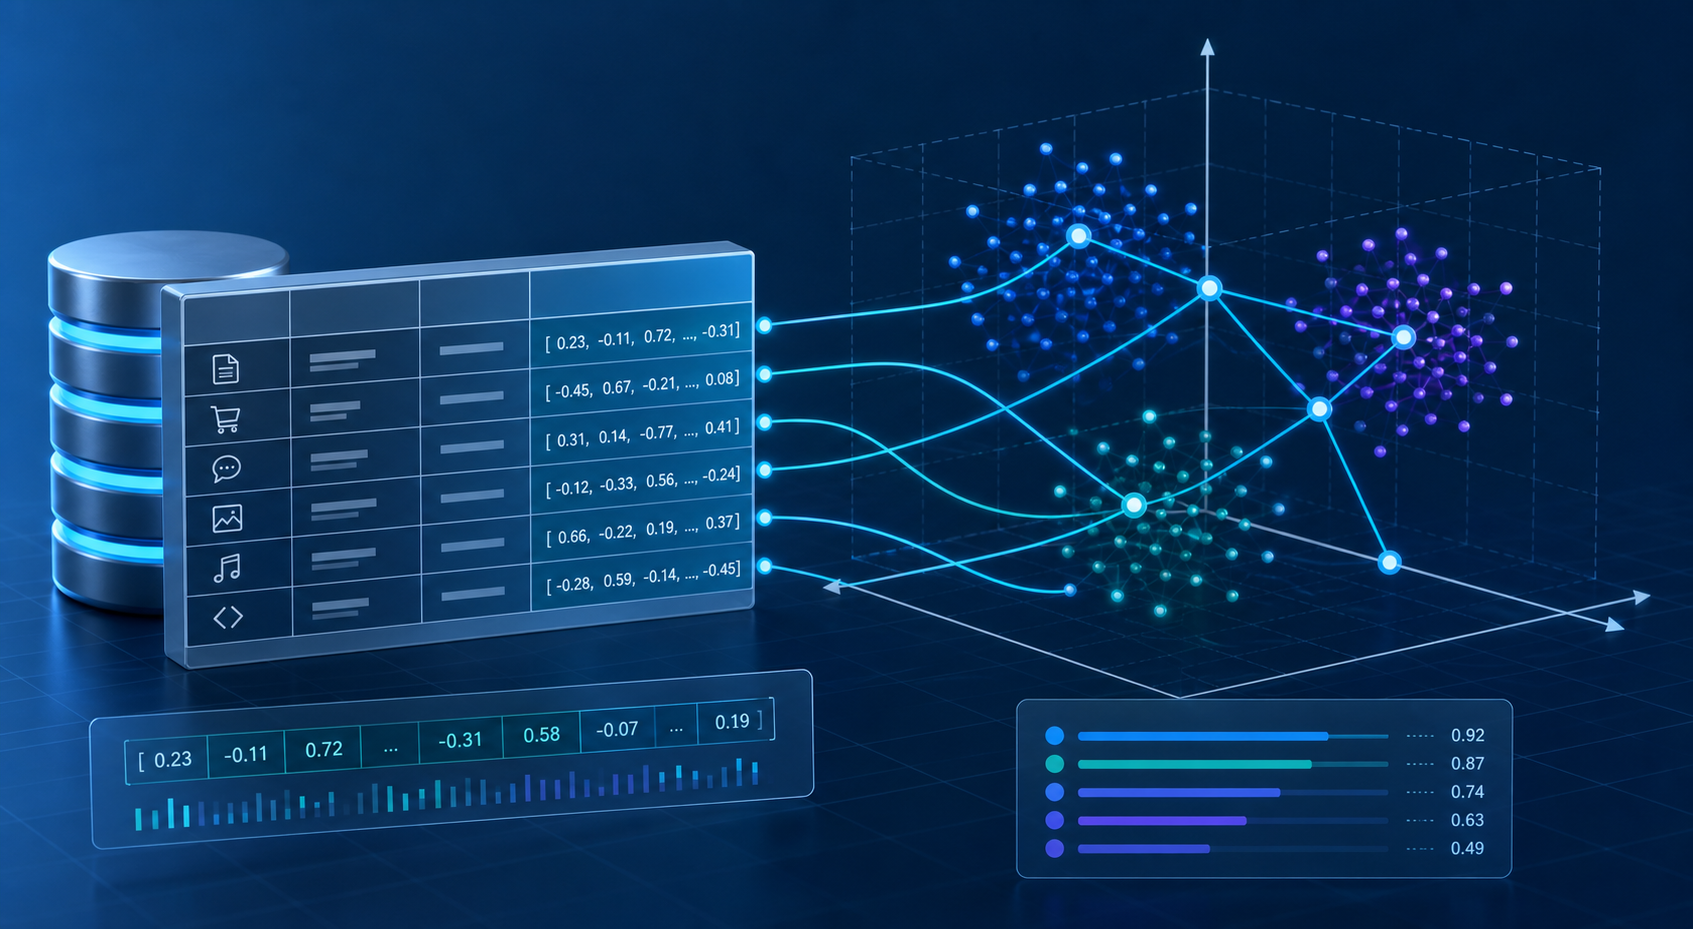
El tipo de datos VECTOR, introducido en Db2 LUW 12.1.2, permite a Db2 almacenar embeddings vectoriales directamente en tablas relacionales y consultarlos con SQL. Esto es relevante cuando se quiere hacer búsqueda por similitud sobre los datos de origen sin enviar los vectores a un almacenamiento separado.
Este artículo es deliberadamente práctico. Crea una pequeña base de datos de lab, carga vectores de ejemplo y muestra cómo ejecutar búsquedas por similitud con VECTOR_DISTANCE.
1. Objetivos de la lab
Al final de la lab deberías poder:
- Crear columnas
VECTORen Db2 LUW - Cargar valores vectoriales con la función escalar
VECTOR - Inspeccionar valores vectoriales con
VECTOR_SERIALIZEyVECTOR_DIMENSION_COUNT - Ejecutar búsquedas por similitud con
VECTOR_DISTANCE - Combinar similitud vectorial con filtros relacionales normales
- Comprender las restricciones actuales más importantes de este tipo de datos
2. Software necesario
Para esta lab necesitas:
- Db2 LUW 12.1.2 o superior en Linux
- Acceso al usuario propietario de la instancia Db2
Nota importante sobre versiones:
- El tipo de datos
VECTORestá disponible a partir de la versión 12.1.2 - IBM documenta soporte para
EXPORTeIMPORTdesde la versión 12.1.2 - IBM documenta soporte para
LOADdesde la versión 12.1.3
Para mantener esta lab simple y portable en 12.1.2 y versiones posteriores, el flujo principal de abajo usa instrucciones INSERT en lugar de LOAD.
3. Qué ofrece el datatype VECTOR
Db2 soporta vectores como tipo de datos nativo con esta forma:
VECTOR(<dimension>, <coordinate-type>)Los tipos de coordenadas soportados actualmente son:
REALoFLOAT32INT8
El tipo de datos tiene longitud fija:
- Cada valor debe contener exactamente el número de coordenadas declarado
- Los vectores solo son compatibles con otros vectores de la misma dimensión y con el mismo tipo de coordenada
Las funciones vectoriales nativas más útiles para el trabajo SQL del día a día son:
| Función | Utilidad práctica |
|---|---|
VECTOR | Convertir una representación textual en un vector almacenado |
VECTOR_SERIALIZE | Convertir un vector de nuevo a forma textual |
VECTOR_DISTANCE | Calcular la distancia de similitud entre dos vectores |
VECTOR_NORM | Calcular la distancia de un vector al vector nulo |
VECTOR_DIMENSION_COUNT | Devolver la dimensión declarada |
Para este artículo:
- Usamos coordenadas
REAL - Nos centramos en el uso SQL dentro de Db2, y no en la generación de embeddings fuera de Db2
4. Crear la base de datos de lab
Antes de crear la base de datos, cambia a la cuenta propietaria de la instancia Db2.
Ejemplo:
su - db2inst1Si el propietario de la instancia tiene otro nombre en tu entorno, sustituye db2inst1 por el nombre correcto.
Ahora crea la base de datos:
db2 "create database VECLAB"5. Crear los objetos del schema
Esta lab usa un modelo simple de búsqueda de documentos:
- Una tabla almacena pequeños fragmentos de texto y metadatos
- Una columna
VECTORalmacena el embedding de cada fragmento
cat > /tmp/veclab_schema.sql <<'SQL'
CONNECT TO VECLAB;

CREATE SCHEMA vecdemo;

CREATE TABLE vecdemo.doc_chunk
(
    chunk_id          BIGINT NOT NULL,
    doc_id            BIGINT NOT NULL,
    source_type       VARCHAR(20) NOT NULL,
    language_code     CHAR(2) NOT NULL,
    topic             VARCHAR(40) NOT NULL,
    title             VARCHAR(120) NOT NULL,
    chunk_text        CLOB(8K) NOT NULL,
    embedding         VECTOR(8, REAL),
    created_ts        TIMESTAMP NOT NULL DEFAULT CURRENT TIMESTAMP,
    PRIMARY KEY (chunk_id)
);

CREATE INDEX vecdemo.ix_doc_chunk_topic
    ON vecdemo.doc_chunk (topic, language_code);

COMMIT;
CONNECT RESET;
SQL

db2 -tvf /tmp/veclab_schema.sql
6. Insertar datos vectoriales de ejemplo
Usamos vectores de ocho dimensiones para mantener la lab legible. Los valores son intencionadamente pequeños para que se vea claramente qué filas están más próximas entre sí.
cat > /tmp/veclab_load.sql <<'SQL'
CONNECT TO VECLAB;

INSERT INTO vecdemo.doc_chunk
    (chunk_id, doc_id, source_type, language_code, topic, title, chunk_text, embedding)
VALUES
    (1, 1001, 'MANUAL', 'EN', 'DB2', 'Db2 backup basics',
     'A short introduction to Db2 backups and recovery.',
     VECTOR('[0.91, 0.87, 0.12, 0.09, 0.18, 0.11, 0.14, 0.10]', 8, REAL)),

    (2, 1002, 'MANUAL', 'EN', 'DB2', 'Db2 restore basics',
     'A short introduction to restore operations and log replay.',
     VECTOR('[0.88, 0.84, 0.10, 0.08, 0.16, 0.10, 0.12, 0.09]', 8, REAL)),

    (3, 1003, 'KB', 'EN', 'LOCKING', 'Lock timeout troubleshooting',
     'Practical checks for timeout events and blocking sessions.',
     VECTOR('[0.12, 0.11, 0.93, 0.89, 0.18, 0.20, 0.09, 0.11]', 8, REAL)),

    (4, 1004, 'KB', 'EN', 'LOCKING', 'Deadlock troubleshooting',
     'Practical checks for deadlock events and conflicting application flows.',
     VECTOR('[0.10, 0.09, 0.90, 0.92, 0.17, 0.18, 0.08, 0.10]', 8, REAL)),

    (5, 1005, 'WIKI', 'EN', 'VECTOR', 'Embedding storage pattern',
     'A note about storing embeddings and original text in the same table.',
     VECTOR('[0.20, 0.18, 0.14, 0.11, 0.95, 0.91, 0.22, 0.19]', 8, REAL)),

    (6, 1006, 'WIKI', 'EN', 'VECTOR', 'Similarity search pattern',
     'A note about nearest-neighbor style search with SQL predicates.',
     VECTOR('[0.18, 0.16, 0.12, 0.10, 0.92, 0.94, 0.21, 0.18]', 8, REAL)),

    (7, 1007, 'WIKI', 'ES', 'VECTOR', 'Patron de almacenamiento de embeddings',
     'Una nota sobre almacenar embeddings y texto original en la misma tabla.',
     VECTOR('[0.19, 0.17, 0.13, 0.11, 0.93, 0.90, 0.23, 0.20]', 8, REAL)),

    (8, 1008, 'WIKI', 'PT', 'VECTOR', 'Padrao de pesquisa por similaridade',
     'Uma nota sobre pesquisa semantica com filtros relacionais adicionais.',
     VECTOR('[0.17, 0.15, 0.11, 0.10, 0.90, 0.93, 0.20, 0.17]', 8, REAL));

COMMIT;
CONNECT RESET;
SQL

db2 -tvf /tmp/veclab_load.sql
7. Inspeccionar el datatype en el catálogo
Confirma que Db2 registró la columna como vector.
db2 connect to VECLAB
db2 "
SELECT
    CAST(RTRIM(colname) AS VARCHAR(20)) AS col,
    CAST(RTRIM(typename) AS VARCHAR(20)) AS type_name,
    CAST(length AS VARCHAR(8)) AS len,
    CAST(nulls AS VARCHAR(4)) AS nul
FROM syscat.columns
WHERE tabschema = 'VECDEMO'
  AND tabname = 'DOC_CHUNK'
ORDER BY colno"
db2 connect reset
Deberías ver EMBEDDING con un tipo vectorial reportado por el catálogo.
8. Inspeccionar valores vectoriales almacenados
El vector se almacena internamente en formato binario. Para inspeccionarlo en la salida SQL, usa VECTOR_SERIALIZE.
db2 connect to VECLAB
db2 "
SELECT
    CAST(chunk_id AS VARCHAR(8)) AS id,
    CAST(RTRIM(topic) AS VARCHAR(12)) AS topic,
    CAST(VECTOR_DIMENSION_COUNT(embedding) AS VARCHAR(6)) AS dim,
    VECTOR_SERIALIZE(embedding) AS vec
FROM vecdemo.doc_chunk
ORDER BY chunk_id
FETCH FIRST 4 ROWS ONLY"
db2 connect reset
Este es el primer punto práctico que conviene retener:
- Las aplicaciones trabajan muchas veces con forma textual, como
'[0.91, 0.87, ...]' - Db2 almacena el valor real como vector
VECTOR_SERIALIZEes la forma más simple de inspeccionar lo que está almacenado
9. Ejecutar una primera búsqueda por similitud
Ahora ejecuta una consulta de tipo nearest-match. El vector de referencia de abajo está intencionadamente próximo a las filas sobre el tema VECTOR.
Para COSINE, una distancia menor significa vectores más similares.
db2 connect to VECLAB
db2 "
WITH query_vec(qv) AS
(
    VALUES VECTOR('[0.19, 0.17, 0.12, 0.10, 0.94, 0.92, 0.22, 0.18]', 8, REAL)
)
SELECT
    CAST(d.chunk_id AS VARCHAR(8)) AS id,
    CAST(RTRIM(d.topic) AS VARCHAR(12)) AS topic,
    CAST(RTRIM(d.language_code) AS VARCHAR(4)) AS lang,
    CAST(RTRIM(d.title) AS VARCHAR(60)) AS title,
    CAST(DECIMAL(VECTOR_DISTANCE(d.embedding, q.qv, COSINE), 16, 8) AS VARCHAR(18)) AS cosine_dist
FROM vecdemo.doc_chunk d,
     query_vec q
WHERE d.embedding IS NOT NULL
ORDER BY VECTOR_DISTANCE(d.embedding, q.qv, COSINE)
FETCH FIRST 5 ROWS ONLY"
db2 connect reset
En una aplicación real, ese vector de consulta vendría de un modelo de embeddings fuera de Db2. Para la lab, basta con proporcionar un literal vectorial fijo.
10. Combinar búsqueda por similitud con filtros relacionales
Aquí es donde el almacenamiento nativo de vectores dentro de Db2 se vuelve útil. Puedes filtrar primero por los metadatos normales y solo después ordenar los candidatos por la distancia vectorial.
El ejemplo de abajo restringe la búsqueda a contenido en inglés procedente del origen WIKI.
db2 connect to VECLAB
db2 "
WITH query_vec(qv) AS
(
    VALUES VECTOR('[0.19, 0.17, 0.12, 0.10, 0.94, 0.92, 0.22, 0.18]', 8, REAL)
)
SELECT
    CAST(d.chunk_id AS VARCHAR(8)) AS id,
    CAST(RTRIM(d.source_type) AS VARCHAR(10)) AS src,
    CAST(RTRIM(d.language_code) AS VARCHAR(4)) AS lang,
    CAST(RTRIM(d.topic) AS VARCHAR(12)) AS topic,
    CAST(RTRIM(d.title) AS VARCHAR(60)) AS title,
    CAST(DECIMAL(VECTOR_DISTANCE(d.embedding, q.qv, COSINE), 16, 8) AS VARCHAR(18)) AS cosine_dist
FROM vecdemo.doc_chunk d,
     query_vec q
WHERE d.embedding IS NOT NULL
  AND d.source_type = 'WIKI'
  AND d.language_code = 'EN'
ORDER BY VECTOR_DISTANCE(d.embedding, q.qv, COSINE)
FETCH FIRST 3 ROWS ONLY"
db2 connect reset
Este patrón suele ser más útil que una búsqueda puramente vectorial:
- Reducir candidatos con predicados relacionales
- Ordenar las filas restantes por similitud vectorial
11. Comparar diferentes métricas de distancia
Db2 soporta varias métricas en VECTOR_DISTANCE, entre ellas:
COSINEEUCLIDEANEUCLIDEAN_SQUAREDDOTHAMMINGMANHATTAN
Estas métricas no significan lo mismo, por lo que conviene elegirlas deliberadamente:
COSINE
Mide la diferencia angular entre dos vectores. En la práctica, esta es la elección más común para embeddings de búsqueda semántica, porque se centra en la orientación y no en la magnitud absoluta.
EUCLIDEAN
Mide la distancia en línea recta entre dos vectores. Es útil cuando la magnitud del vector forma parte de la señal y no solo su dirección.
EUCLIDEAN_SQUARED
Es similar a la distancia euclidiana, pero sin la raíz cuadrada. Conserva la ordenación relativa de la distancia euclidiana, aunque en una escala numérica diferente.
DOT
Calcula el producto escalar y no una distancia geométrica en el sentido habitual. Solo es útil cuando el método de embeddings o la lógica de ordenación aguas arriba se ha diseñado explícitamente en torno a la similitud por producto escalar.
MANHATTAN
Mide la distancia como la suma de las diferencias absolutas coordenada a coordenada. Es menos común para embeddings semánticos, pero puede seguir siendo útil en algunos modelos de features numéricos.
HAMMING
Cuenta diferencias de coordenadas de forma discreta y normalmente solo es relevante para codificaciones vectoriales específicas, sobre todo cuando los datos se comportan más como símbolos discretos que como embeddings continuos.
- Empieza con
COSINEpara embeddings de búsqueda semántica y escenarios RAG - Usa
EUCLIDEANsolo cuando el flujo de embeddings o la documentación del modelo asuman distancia euclidiana - Evita mezclar métricas entre pruebas y producción, porque las filas más cercanas pueden cambiar
El ejemplo de abajo limita la comparación a COSINE y EUCLIDEAN.
db2 connect to VECLAB
db2 "
WITH query_vec(qv) AS
(
    VALUES VECTOR('[0.19, 0.17, 0.12, 0.10, 0.94, 0.92, 0.22, 0.18]', 8, REAL)
)
SELECT
    CAST(d.chunk_id AS VARCHAR(8)) AS id,
    CAST(RTRIM(d.title) AS VARCHAR(60)) AS title,
    CAST(DECIMAL(VECTOR_DISTANCE(d.embedding, q.qv, COSINE), 16, 8) AS VARCHAR(18)) AS cosine_dist,
    CAST(DECIMAL(VECTOR_DISTANCE(d.embedding, q.qv, EUCLIDEAN), 16, 8) AS VARCHAR(18)) AS euclid_dist
FROM vecdemo.doc_chunk d,
     query_vec q
WHERE d.embedding IS NOT NULL
ORDER BY d.chunk_id"
db2 connect reset
En el trabajo práctico, el punto esencial es no mezclar métricas sin criterio. Elige una métrica para el flujo de búsqueda y mantenla consistente entre la generación de embeddings y la lógica de ordenación.
12. Usar VECTOR_NORM para inspeccionar magnitud
VECTOR_NORM mide la distancia de un vector al vector nulo. En la práctica, esto es útil cuando se quiere inspeccionar la magnitud y no la distancia entre dos filas.
Usos típicos:
- Comprobar si embeddings del mismo pipeline tienen una magnitud aproximadamente comparable
- Detectar valores sospechosos, como vectores inesperadamente próximos a cero
- Validar si un paso de preprocesamiento parece haber producido vectores normalizados o no
Esto importa porque algunos flujos de similitud asumen vectores ya normalizados, mientras que otros no. VECTOR_NORM te da una comprobación rápida del lado SQL antes de comparar un gran número de filas.
db2 connect to VECLAB
db2 "
SELECT
    CAST(chunk_id AS VARCHAR(8)) AS id,
    CAST(RTRIM(title) AS VARCHAR(60)) AS title,
    CAST(DECIMAL(VECTOR_NORM(embedding, EUCLIDEAN), 16, 8) AS VARCHAR(18)) AS vec_norm
FROM vecdemo.doc_chunk
WHERE embedding IS NOT NULL
ORDER BY chunk_id"
db2 connect reset
Si los valores devueltos por VECTOR_NORM están todos en una banda estrecha, eso sugiere que los embeddings se generaron con una magnitud relativamente consistente. Si una fila es mucho menor o mucho mayor que el resto, esa fila merece ser inspeccionada antes de confiar en los resultados de similitud.
13. Exportar valores vectoriales de nuevo a forma textual
Db2 exporta los vectores como strings. Esto permite mover vectores entre tablas o entornos sin exponer directamente la representación binaria interna.
Esta lab mantiene el ejemplo simple con EXPORT.
db2 connect to VECLAB
db2 "export to /tmp/vecdemo_chunks.del of del modified by nochardel
select chunk_id, topic, vector_serialize(embedding)
from vecdemo.doc_chunk
order by chunk_id"
db2 connect reset
Ahora inspecciona el fichero generado:
sed -n '1,5p' /tmp/vecdemo_chunks.delLos valores vectoriales deberían aparecer en formato textual entre corchetes.
14. Restricciones actuales que importan en la práctica
La implementación actual es útil, pero no es “solo otro tipo escalar”. Algunas restricciones importan inmediatamente en el trabajo de diseño:
- Una columna vectorial no puede ser primary key, foreign key, unique key ni index key
- Los vectores no pueden compararse directamente
- No puedes usar una columna vectorial como clave de
ORDER BYpor sí sola - Una columna no vectorial existente no puede alterarse a
VECTOR - Una columna vectorial existente no puede alterarse a otro tipo de coordenada o dimensión
- El único valor default permitido es
NULL
15. Lo que esto significa desde el punto de vista arquitectónico
El mayor valor del datatype VECTOR no es que Db2 pase de repente a ser una plataforma “end-to-end” de embeddings. El valor está en poder mantener:
- El contenido original
- Los metadatos
- Los embeddings vectoriales
- La lógica SQL de filtrado
en el mismo motor de base de datos.
Esto resulta especialmente útil para:
- Búsqueda semántica sobre artículos de conocimiento
- Flujos de estilo RAG sobre contenido interno gobernado
- Búsqueda por similitud que también deba respetar predicados de negocio como idioma, origen, categoría, tenant o fecha de validez
16. Resumen
El datatype VECTOR en Db2 LUW 12.1.2 y posteriores ofrece almacenamiento nativo para embeddings dentro de tablas relacionales.
Esta lab mostró el núcleo práctico de la funcionalidad:
- Definir una columna
VECTOR - Insertar vectores con la función escalar
VECTOR - Inspeccionarlos con
VECTOR_SERIALIZE - Calcular similitud con
VECTOR_DISTANCE - Combinar ordenación semántica con filtrado relacional normal
Este es un patrón útil para la mayoría de los equipos. El modelo de embeddings puede permanecer fuera de Db2, mientras que el almacenamiento, el filtrado y la ordenación permanecen en SQL.
17. Documentación útil de IBM
Para profundizar, las referencias de IBM más útiles para este tema son:
- Mejoras SQL de Db2 12.1.2
- Visión general de valores VECTOR y del datatype
- Función escalar
VECTOR - Función escalar
VECTOR_DISTANCE - Función escalar
VECTOR_NORM - Función escalar
VECTOR_DIMENSION_COUNT - Función escalar
VECTOR_SERIALIZE
18. Limpieza
Cuando termines la lab, elimina la base de datos y los ficheros temporales:
db2 force applications all
db2 drop database VECLAB
rm -f /tmp/veclab_schema.sql \
      /tmp/veclab_load.sql \
      /tmp/vecdemo_chunks.del